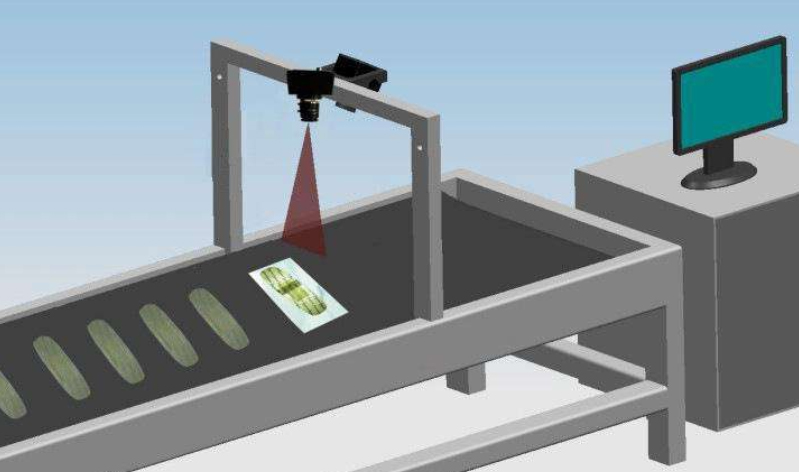
工業視覺缺陷檢測算法并非單一存在,而是形成了以傳統圖像算法為基礎、CV(計算機視覺)算法為核心、兩者融合為補充的多元化體系。不同算法適配不同場景,共同滿足工業生產的多樣化檢測需求。
沒有完美的算法,只有適配的算法。了解不同算法的優缺點,才能根據實際場景精準選擇,實現檢測效果與成本的平衡。
1. 傳統圖像算法:高效但受限
優點十分突出:計算效率高,能快速完成檢測,適配實時性要求高的場景;可解釋性強,基于明確的數學模型和物理原理,工程師能清晰理解運行邏輯,方便調整優化;小樣本適應性好,無需大量數據,憑借預設特征就能完成檢測。
局限性也很明顯:泛化能力弱,環境、產品材質、光照等微小變化都可能影響檢測精度,需要重新調整參數;對特征工程依賴高,需要工程師具備豐富經驗設計特征提取方法,耗時耗力;對微小缺陷檢測能力不足,容易被噪聲干擾,難以識別細微瑕疵。
2. CV算法:智能但有門檻
優勢極為顯著:微小缺陷檢測精度高,憑借深度學習模型強大的特征學習能力,能捕捉到微米級的細微缺陷;復雜場景適應性強,面對背景復雜、光照不均、物體遮擋等情況,仍能精準提取特征、識別缺陷。
但應用門檻較高:數據需求極大,需要收集大量標注數據,涵蓋各類正常與缺陷場景,耗費大量時間和人力成本;計算資源要求高,訓練和運行模型需要高性能GPU支持,增加了硬件成本;模型訓練耗時長,復雜模型的訓練可能需要數小時甚至數天;可解釋性差,模型如同“黑盒子”,能給出檢測結果但無法清晰解釋決策依據,在對安全性要求極高的場景中應用受限。